设计师
探索融合文字与图像的海报、标题图和版式概念。用结构化提示词表达关键元素应出现的位置。

创作包含中英文文字和丰富场景细节的图像,选择摄影或插画风格。MOSS Image 还支持 JSON 布局,用于引导文字和物体的位置。
将文字、视觉细节与构图融入同一提示词的图像模型。
MOSS Image 的官方名称为 MOSS-Image,是 OpenMOSS 于 2026 年 10 月 16 日发布的文生图模型家族。其主干网络拥有 50 亿参数,支持最长 4K token 的提示词,可生成摄影和插画风格的图像。
该家族包括 MOSS-Image-Base 和 MOSS-Image-SFT。SFT 由 Base 使用精选数据微调而来,两者采用相同的架构和提示词接口。它们是同一次发布中的两个模型检查点,而非先后迭代的两代模型。
选择描述目标图像的方式:
布局提示词属于实验性功能。使用图像前,请检查生成的文字和位置。
修改布局会生成新的构图,并不意味着支持编辑上传的照片。
六张 OpenMOSS 已公开的示例,涵盖手写文字、插画与全景场景。
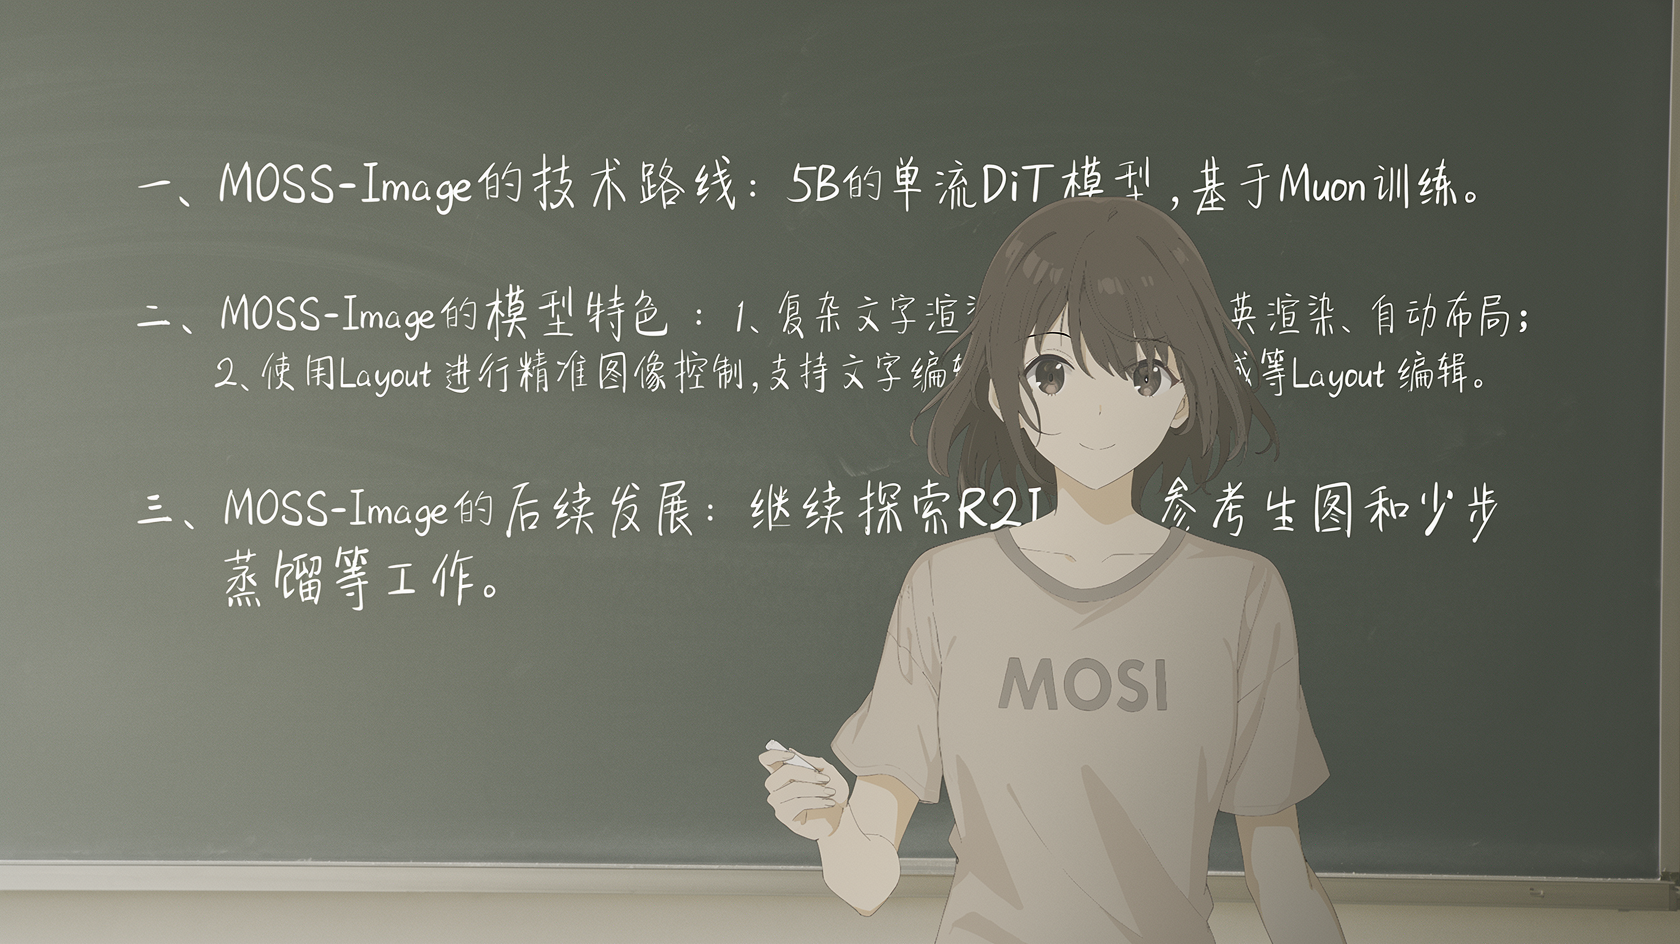
MOSS Image
插画教室里的手写文字
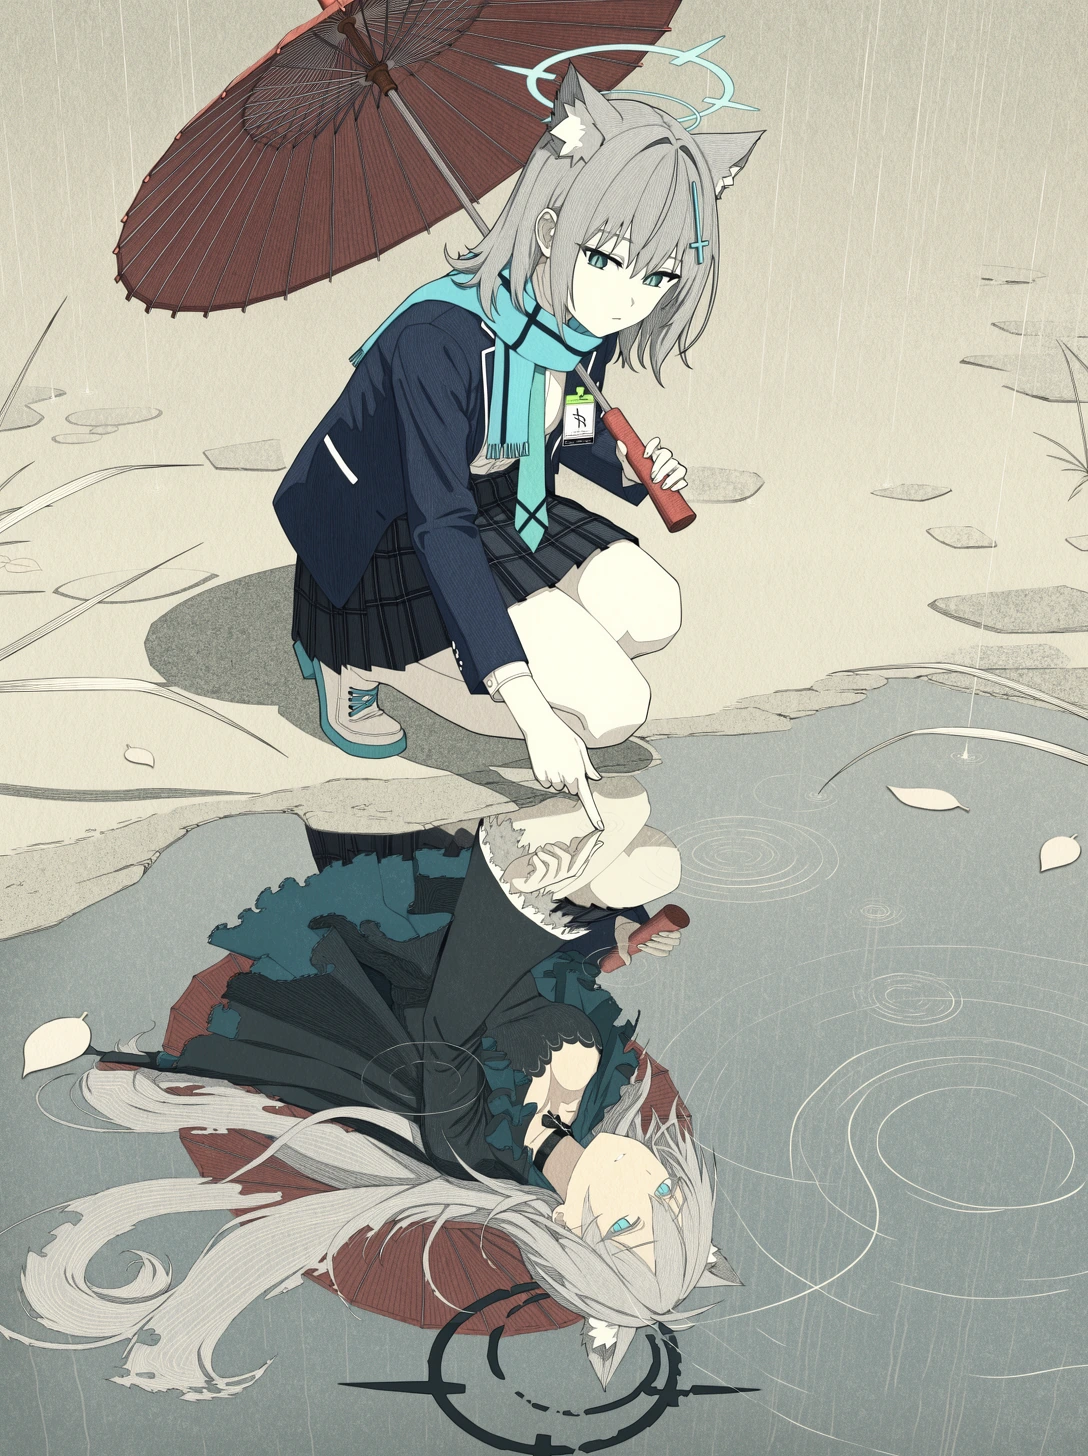
MOSS Image
雨中的倒影
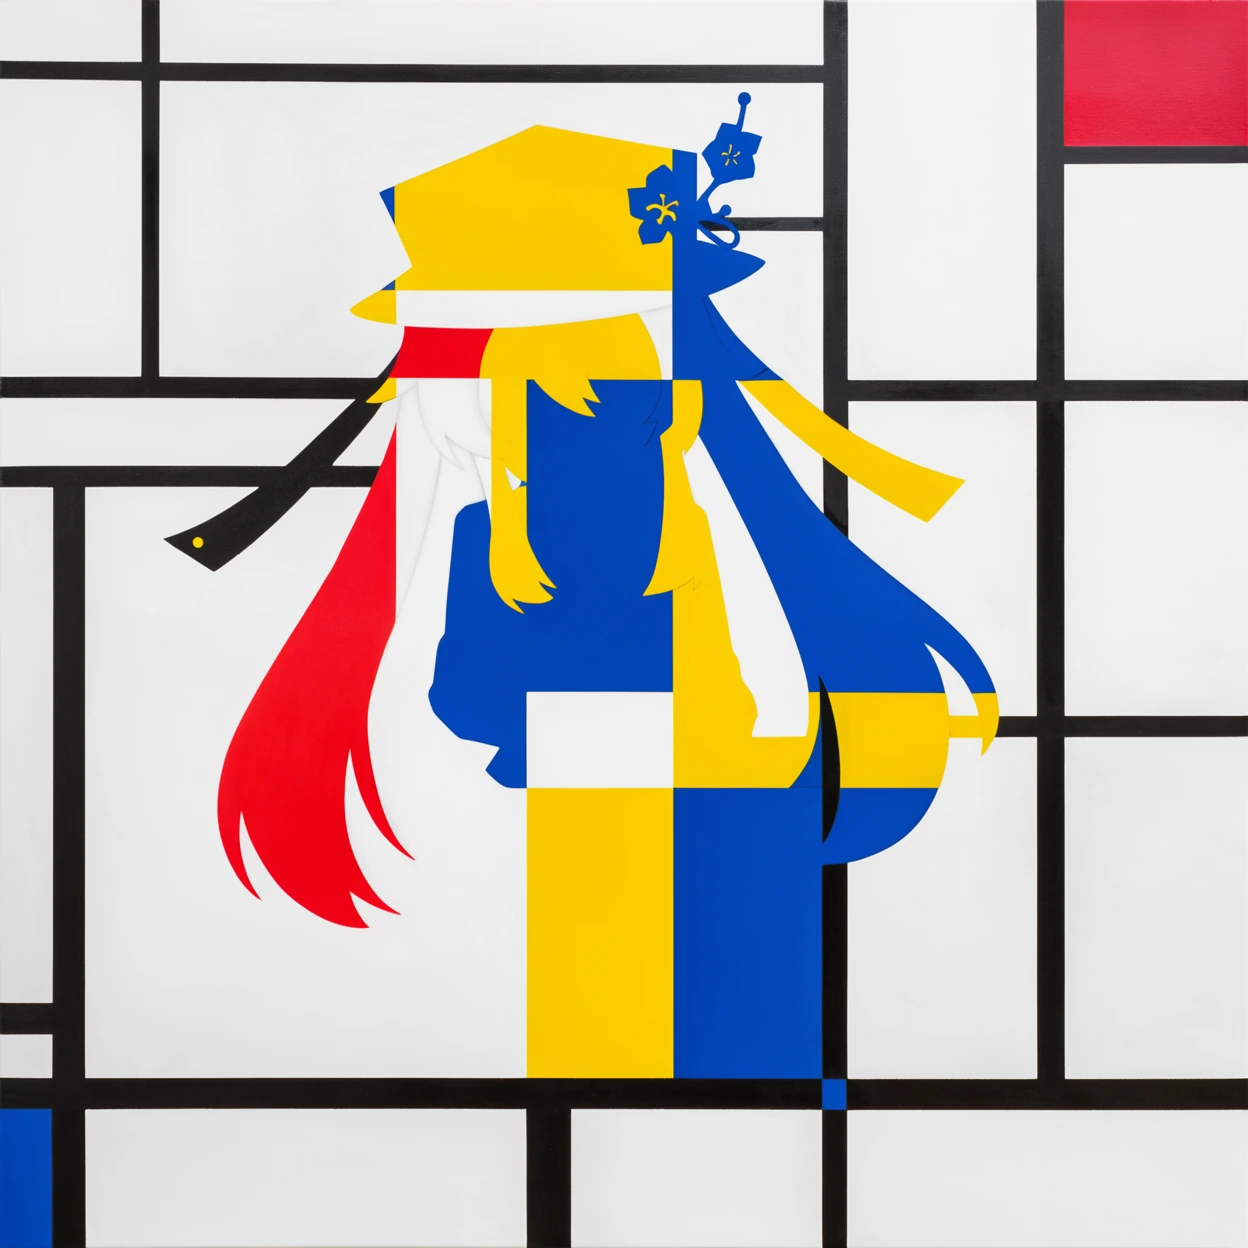
MOSS Image
鲜明的几何形状与原色
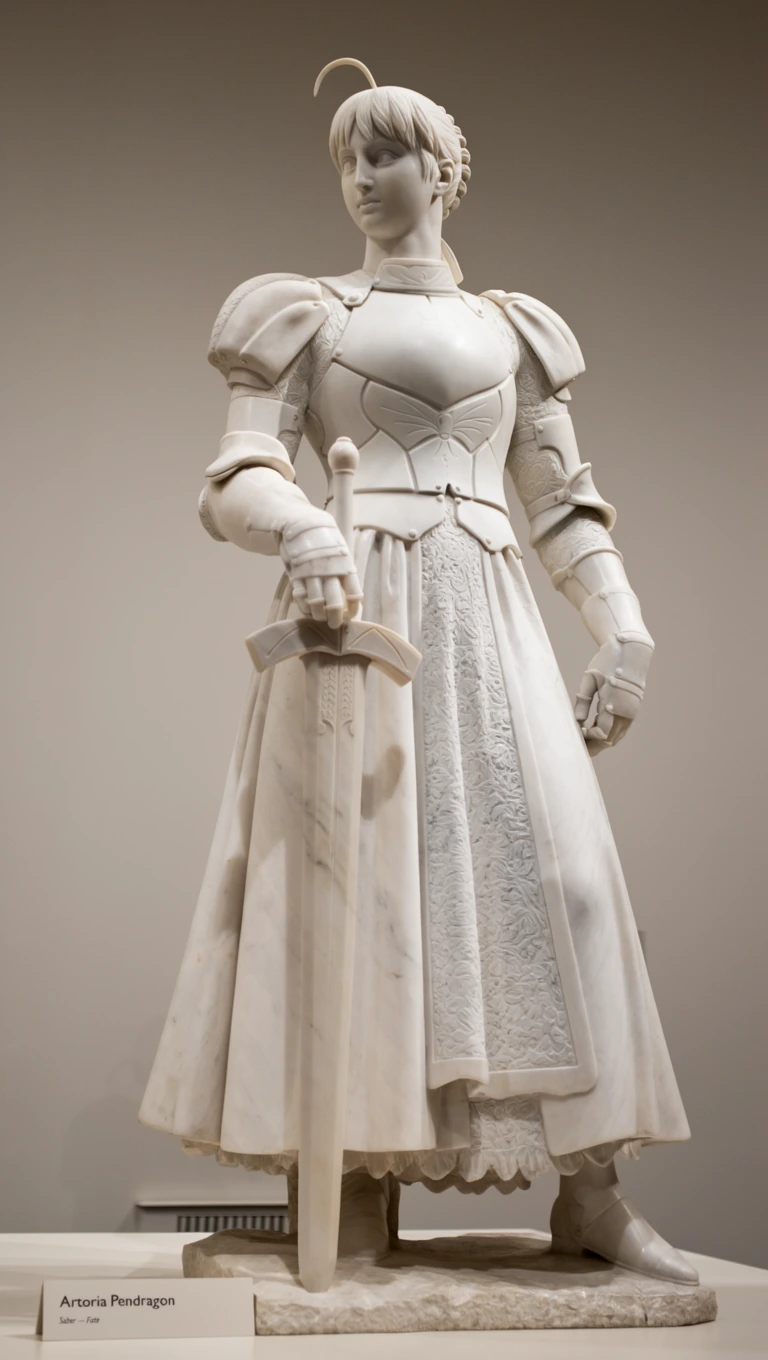
MOSS Image
细节丰富的大理石雕像
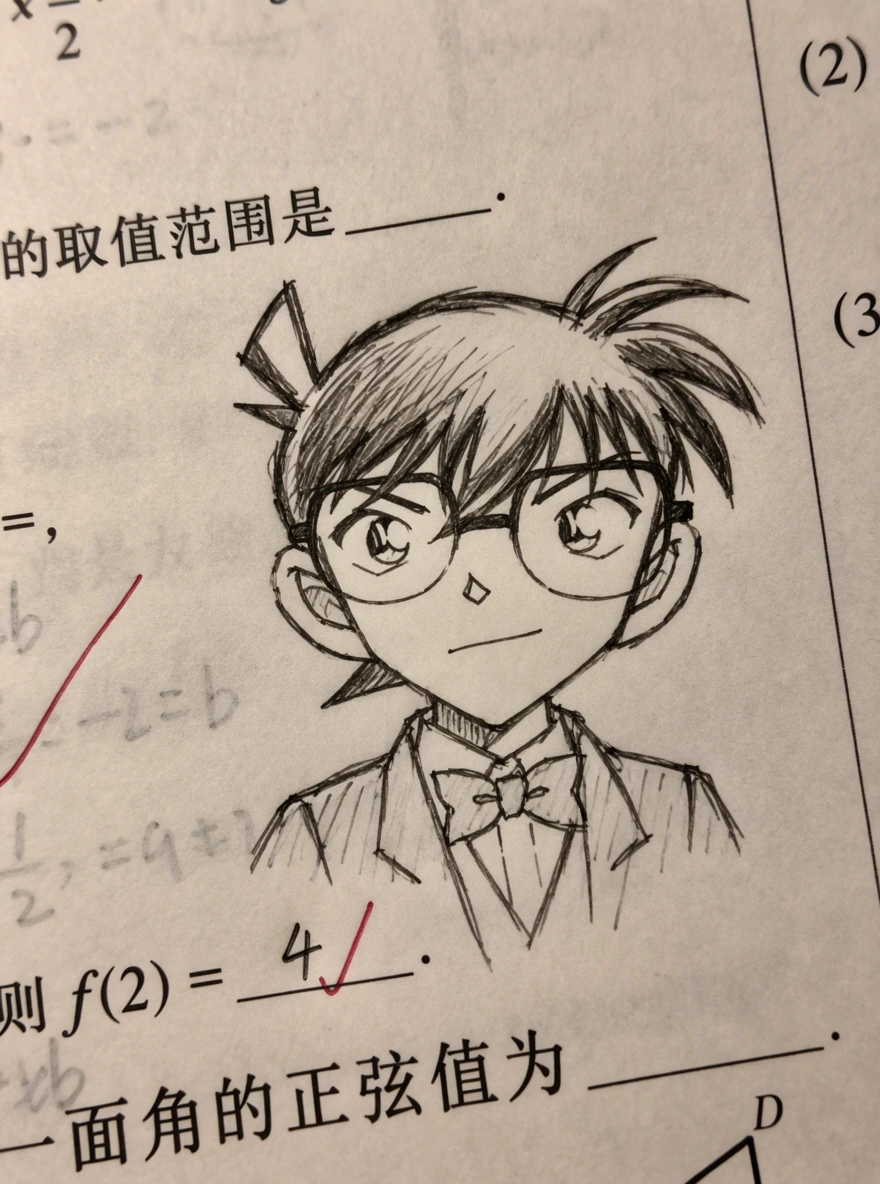
MOSS Image
习题纸上的铅笔线条
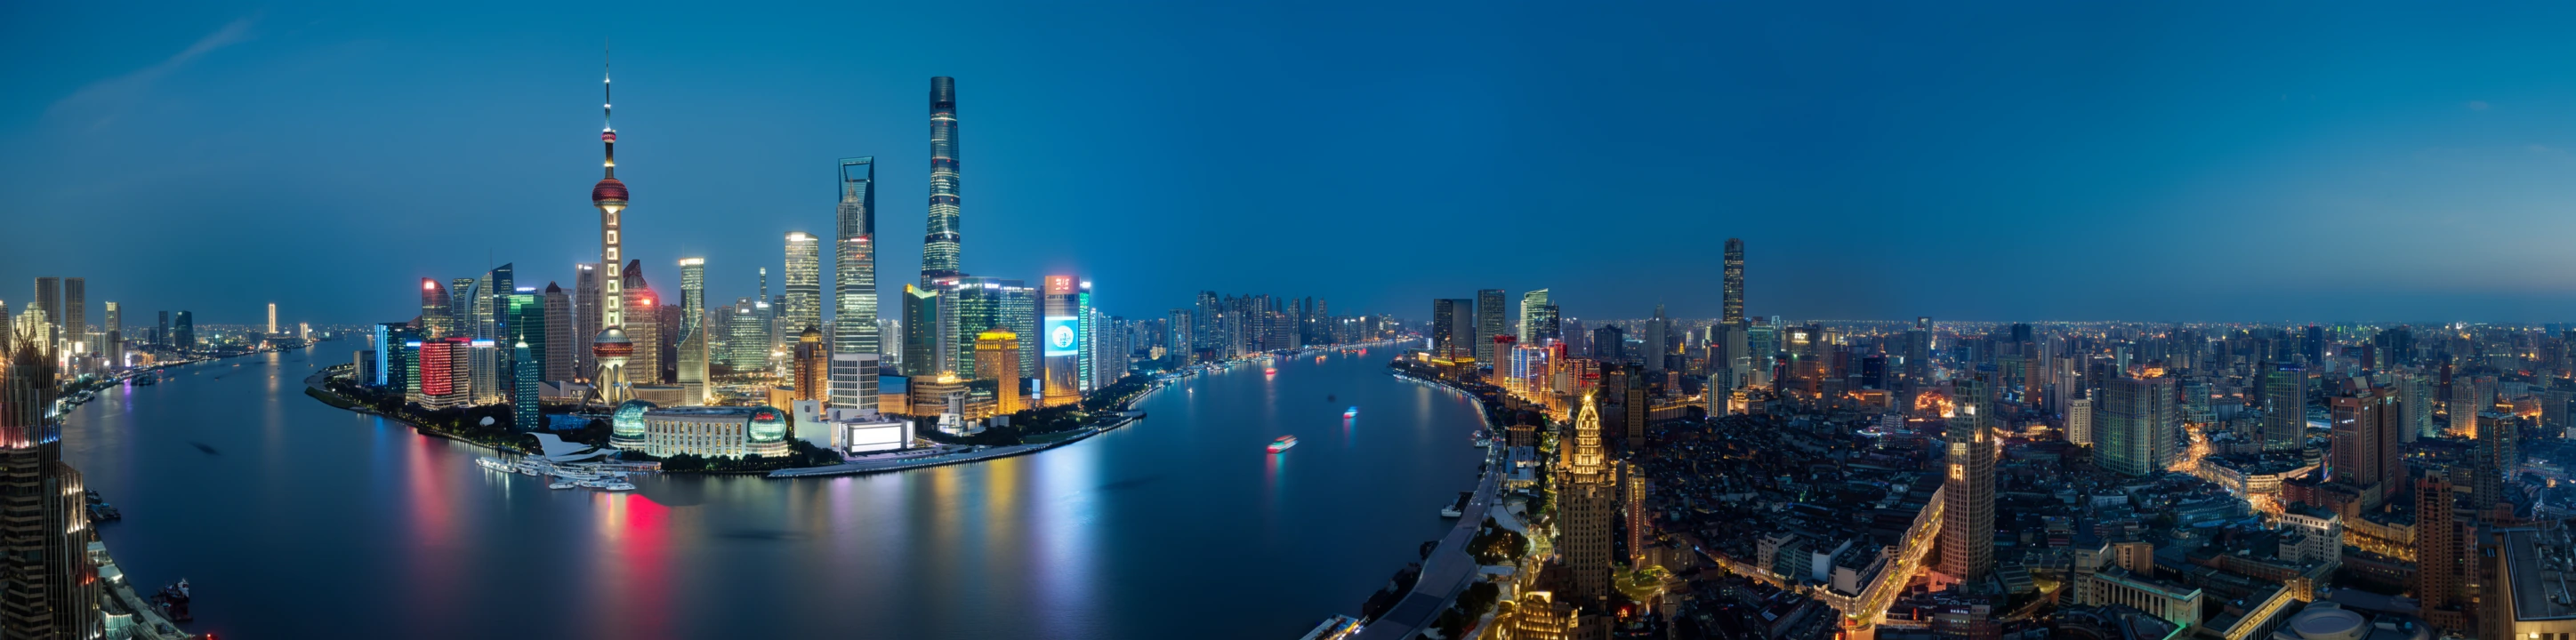
MOSS Image
上海天际线全景
了解将视觉创意转化为细腻图像的六项能力。
将文字直接融入图像,从便签、标识到较长的段落。描述准确的文字内容和预期换行,再检查结果中的拼写与遗漏。
用描述和边界框引导文字与物体的位置。这种实验性输入格式可表达预期构图,但不保证像素级精确定位。
提示词最长可达 4K token,便于描述多个主体、材质、光照及其在场景中的相互关系。
探索写实场景、动漫、素描和图形艺术。公开示例展示了同一模型家族的多种视觉风格。
在 Picir AI 上选择方形、竖向或横向图像,支持 1:1、4:3、3:4、16:9 和 9:16 五种宽高比。输出固定为 1K,可选 JPEG、PNG 或 WebP 格式。
编写自然语言描述、使用标签,或将文字描述与结构化布局结合。可以从简单描述开始,再按需要补充更明确的构图指引。
将文字、插画和构图控制用于多种视觉创作项目。
探索融合文字与图像的海报、标题图和版式概念。用结构化提示词表达关键元素应出现的位置。
设计角色、氛围场景和故事插画概念。在详细提示词中描述情绪、材质和视觉关系。
为帖子或演示文稿创作公告图、双语视觉内容和图像概念。分享前检查每个生成的标题。
为讲解内容探索教室场景、手写笔记和带文字的插画。检查成品图像的文字内容与事实准确性。
描述创意、选择图像设置,再使用 MOSS Image 生成图片。
写明主体、场景、视觉风格和希望呈现的文字。官方指南推荐使用英文,也支持中文提示词。
选择宽高比以及 JPEG、PNG 或 WebP 输出格式。MOSS Image 固定使用 1K 设置;可选择要生成的图片数量。
生成图片后,在工作台查看结果。检查文字与构图,调整提示词以生成其他版本。
Picir AI 上可用的模型信息与图像生成设置。
| 开发团队 | OpenMOSS Team |
| 发布日期 | 2026 年 10 月 16 日 |
| 生成模式 | 文生图 |
| 模型架构 | 50 亿参数的扩散 Transformer |
| 提示词格式 | 自然语言、标签序列和 JSON 布局 |
| Picir AI 提示词输入上限 | 最多 5,000 个字符 |
| 文字渲染 | 中文和英文 |
| 输出分辨率 | 1K(固定) |
| 宽高比 | 1:1, 4:3, 3:4, 16:9, 9:16 |
| 输出格式 | JPEG, PNG, WebP |
| 布局控制 | 通过 JSON 提示词进行实验性的文字与物体定位 |
| 参考图片 | 不支持图片上传;请在提示词中描述图像 |
更新日期: 2026年10月21日
比较 MOSS Image 家族同时发布的两个模型检查点。
| 规格 | MOSS-Image-Base | MOSS-Image-SFT |
|---|---|---|
| 发布日期 | 2026 年 10 月 16 日 | 2026 年 10 月 16 日 |
| 检查点定位 | 基础模型 | 使用精选数据在 Base 基础上微调 |
| 主干网络 | 50 亿参数 | 相同的 50 亿参数架构 |
| 提示词格式 | 自然语言、标签、JSON 布局 | 自然语言、标签、JSON 布局 |
| 提示词窗口 | 最长 4K token | 同一家族的共享接口 |
| 文字渲染 | 中文和英文 | 中文和英文 |
| 布局控制 | 实验性功能 | 共享布局接口 |
| 官方白板示例 | 文字分组相对松散 | 文字分组更清晰,布局更有条理 |
MOSS-Image-Base 的优势: Base 保留基础检查点,便于适配和自定义微调,包括 LoRA 训练。
MOSS-Image-SFT 的优势: SFT 通过精选数据微调,在官方白板对比中展示了更清晰的文字分组。
评估开箱即用的图像质量时可考虑 SFT,计划适配或微调时可考虑 Base。请使用自己的提示词比较两者:单个公开示例不能证明某个模型在所有任务中都更好。
选择 Picir AI 套餐,使用积分通过 MOSS Image 生成图像。下方列出了当前每张图片的费用。
MOSS Image 按每张生成图片收取固定积分。以下示例展示固定 1K 设置下生成一张图片的费用。
| 图像设置 | 每张图片所需积分 |
|---|---|
| 方形 · 1:1 · JPEG · 1K | 8 |
| 横向 · 16:9 · PNG · 1K | 8 |
| 竖向 · 9:16 · WebP · 1K | 8 |
宽高比和输出格式不影响单张费用。生成多张图片时,每张图片分别计费。
了解提示词、布局、模型版本与图像生成限制。
MOSS Image 是 OpenMOSS 的文生图模型家族,拥有 50 亿参数的主干网络。它于 2026 年 10 月 16 日发布,包括 Base 和 SFT 检查点,支持摄影和插画风格的图像输出。
可以。这两项能力均有文档说明,公开示例展示了手写文字及场景中的文字。仍需检查拼写、换行和内容完整性。
不能。官方指南将布局提示词标为实验性功能。边界框用于引导构图,因此文字或物体的位置、尺寸可能与要求不同。
Picir AI 上的 MOSS Image 根据文字生成新图像,不接受上传的参考图片。修改 JSON 布局会创建新的构图,而不是编辑现有照片。
在 Picir AI 上,MOSS Image 固定使用 1K 设置,支持 1:1、4:3、3:4、16:9 和 9:16 宽高比。可选择 JPEG、PNG 或 WebP 输出格式。分辨率为固定值,不提供切换选项。
描述主体、场景、风格、光照以及希望呈现的准确文字。官方指南推荐使用英文提示词,并为文字明确指定换行。也可以结合自然语言、标签和 JSON 布局。
SFT 由 Base 使用精选数据微调而来。两者共享相同的架构和提示词接口;SFT 并非参数更大或更新一代的模型。官方白板示例中,SFT 的文字分组更清晰。
你可以在 Picir AI 使用 MOSS Image AI 图片生成器。输入提示词、选择图像设置,即可直接从本页开始生成图片。