Diseñadores
Explora pósteres, gráficos de título y conceptos de diseño que combinen texto e imágenes. Utiliza prompts estructurados para indicar dónde deben aparecer los elementos principales.

Crea imágenes con texto chino e inglés, escenas detalladas y estilos fotográficos o ilustrados. MOSS Image también acepta diseños JSON para orientar la posición del texto y los objetos.
Un modelo de imagen que reúne texto, detalle visual y composición en un solo prompt.
MOSS Image, cuyo nombre oficial es MOSS-Image, es una familia de modelos de texto a imagen de OpenMOSS, publicada el 16 de octubre de 2026. Su red principal de 5.000 millones de parámetros admite prompts de hasta 4K tokens y puede generar imágenes fotográficas e ilustradas.
La familia incluye MOSS-Image-Base y MOSS-Image-SFT. SFT se obtiene mediante el ajuste fino de Base con datos seleccionados; ambos utilizan la misma arquitectura e interfaz de prompts. Son dos checkpoints de la misma publicación, no generaciones sucesivas del modelo.
Elige cómo describir la imagen que quieres crear:
Los prompts de diseño son experimentales. Revisa el texto generado y su posición antes de utilizar una imagen.
Cambiar un diseño genera una nueva composición; no implica que se puedan editar fotos subidas.
Seis ejemplos publicados por OpenMOSS, desde texto manuscrito hasta ilustraciones y escenas panorámicas.
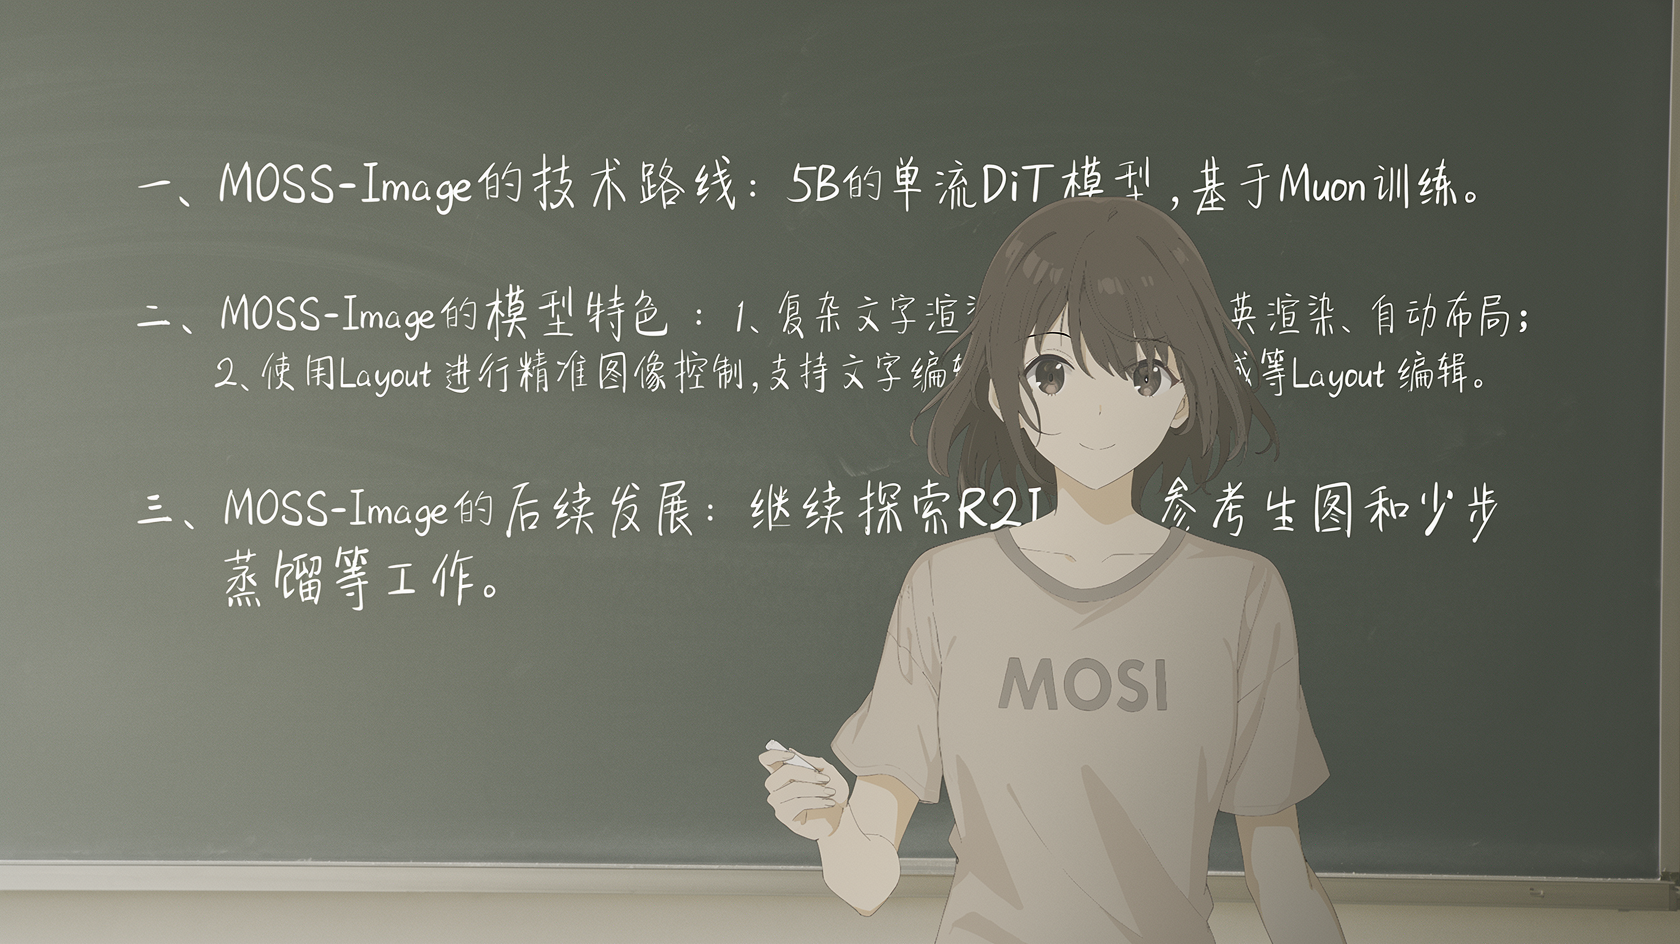
MOSS Image
Texto manuscrito en un aula ilustrada
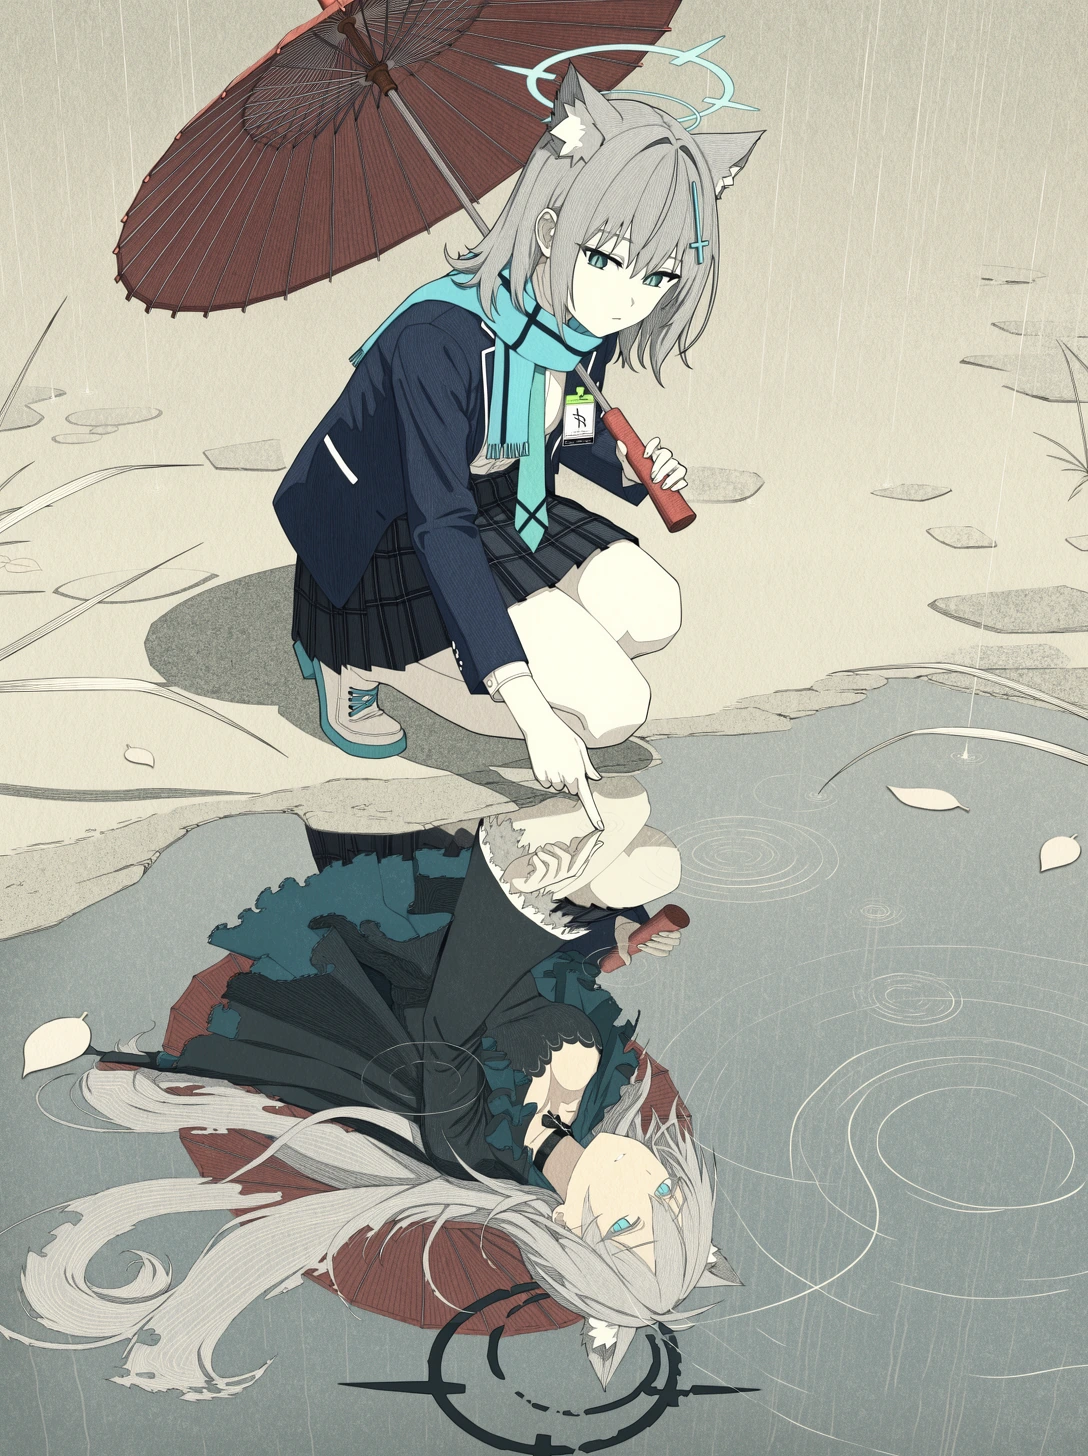
MOSS Image
Un reflejo bajo la lluvia
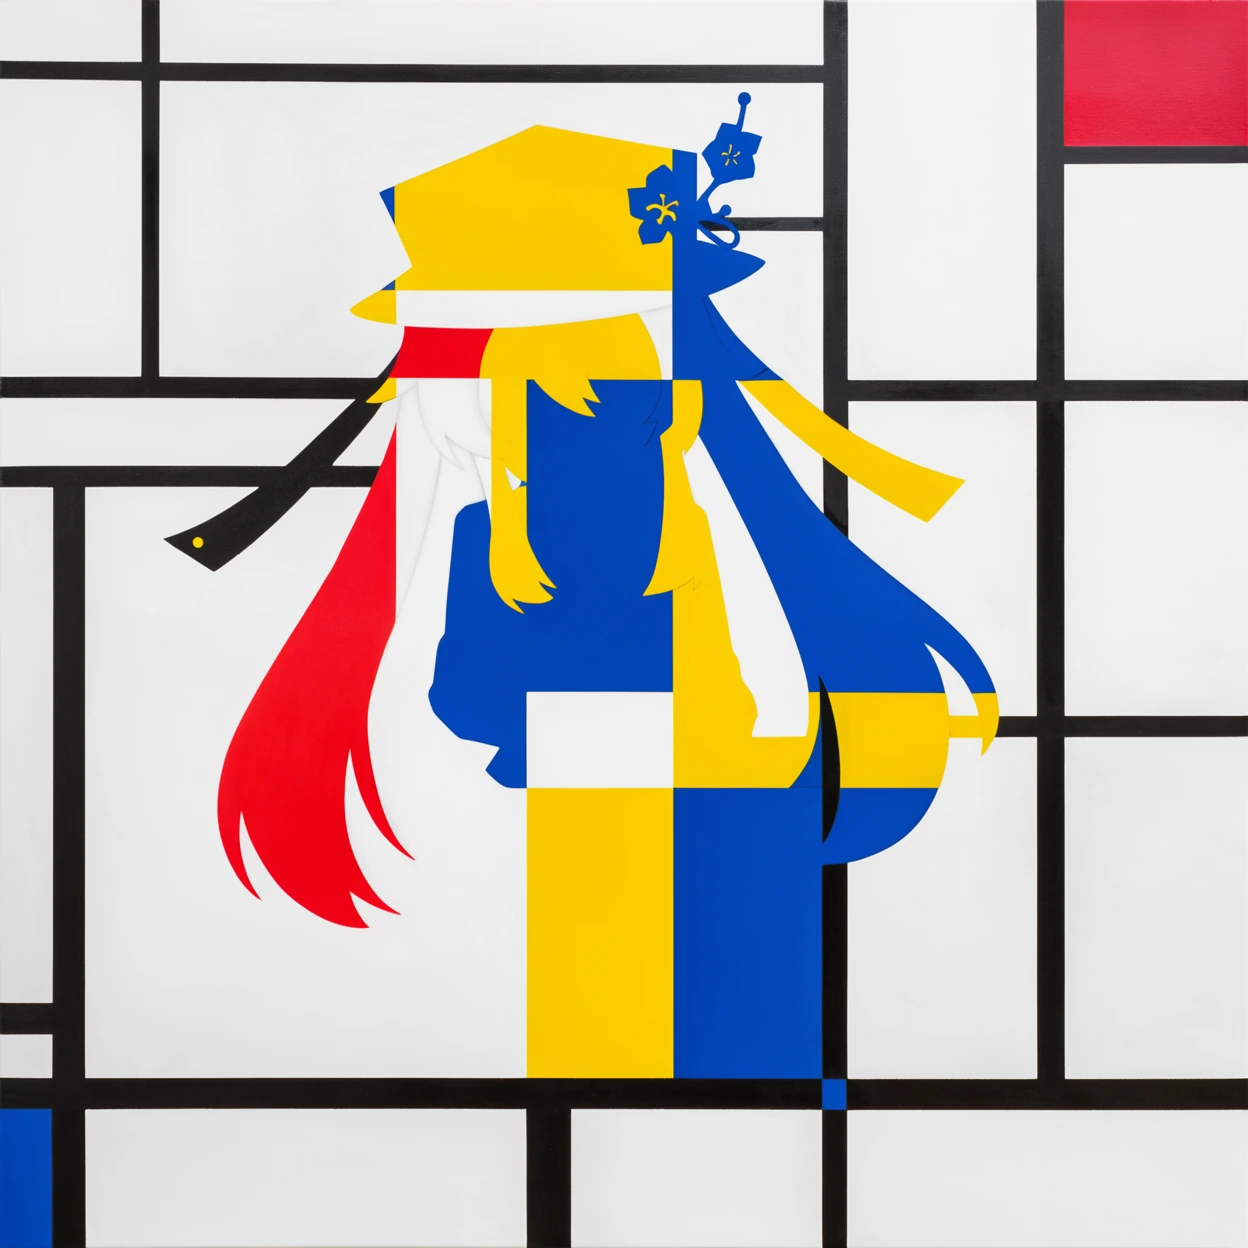
MOSS Image
Formas llamativas y colores primarios
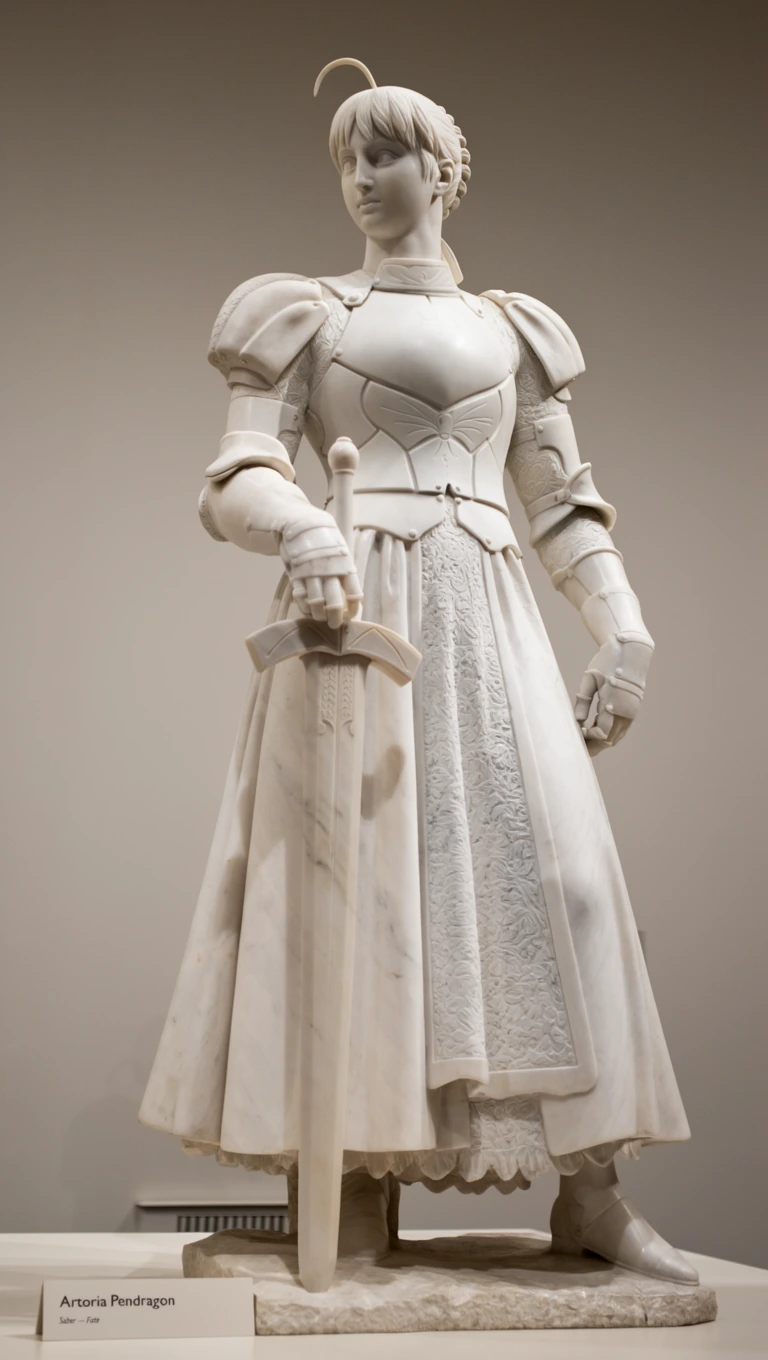
MOSS Image
Una figura de mármol con detalles esculpidos
MOSS Image
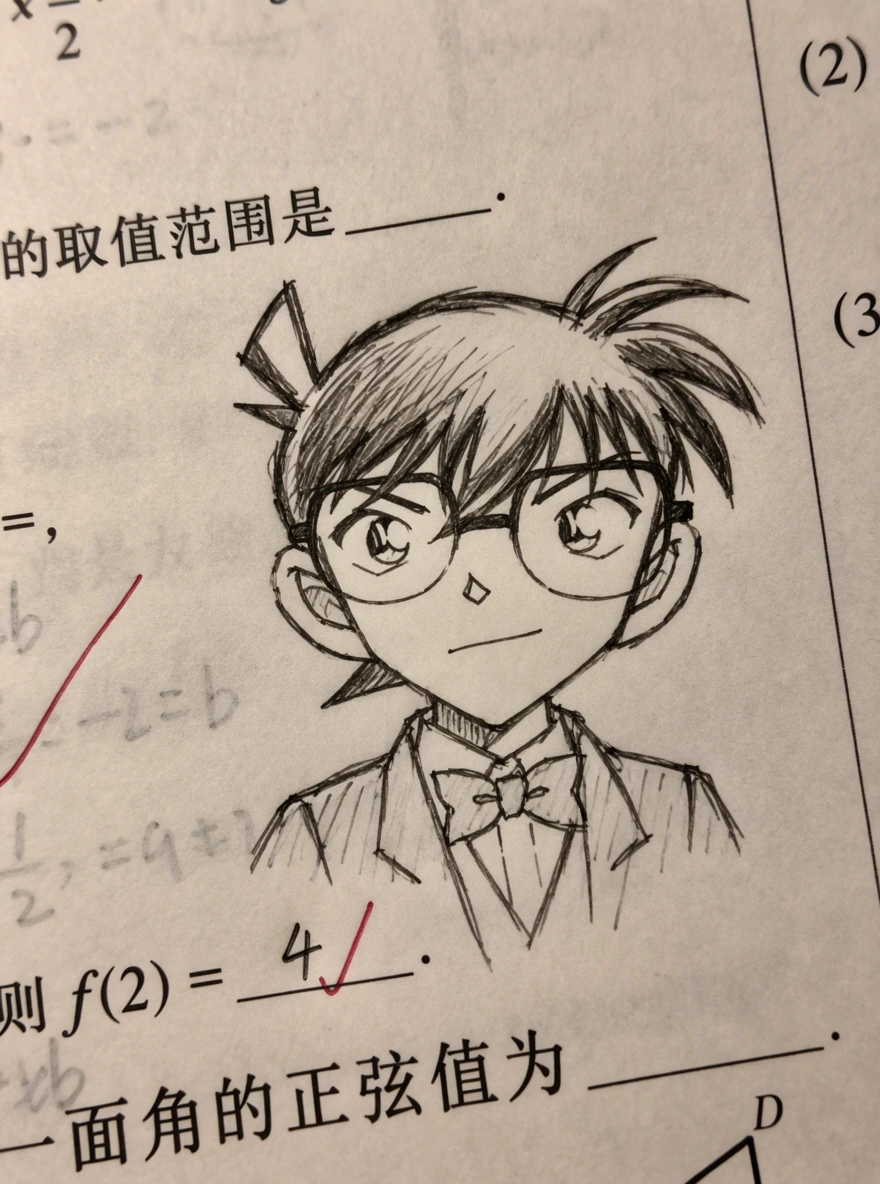
Trazos de lápiz sobre una hoja de ejercicios
MOSS Image
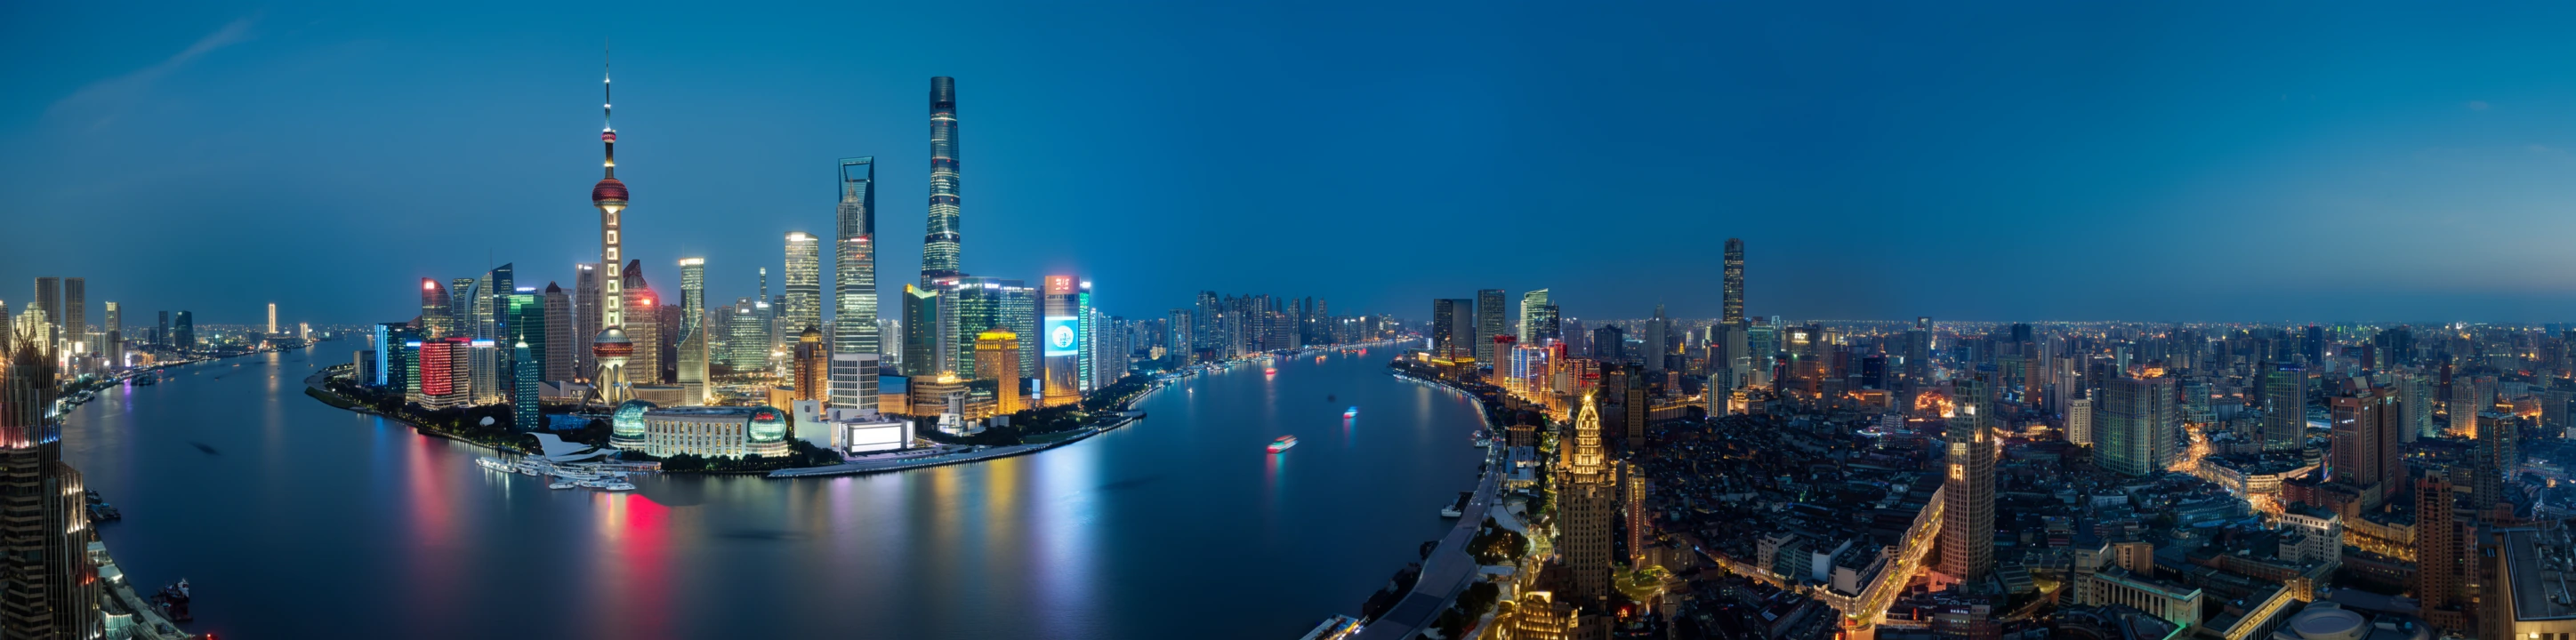
Panorámica del horizonte de Shanghái
Descubre seis capacidades que ayudan a convertir una idea visual en una imagen detallada.
Integra palabras directamente en una imagen, desde notas y carteles hasta pasajes más largos. Describe el texto exacto y los saltos de línea deseados; después revisa la ortografía y las posibles omisiones.
Orienta la posición del texto y los objetos con descripciones y cuadros delimitadores. Este formato de entrada experimental expresa la composición deseada, sin garantizar una colocación exacta al píxel.
Los prompts pueden contener hasta 4K tokens, lo que permite describir varios sujetos, materiales, la iluminación y sus relaciones dentro de una escena.
Explora escenas realistas, anime, bocetos y arte gráfico. Los ejemplos publicados muestran distintos estilos visuales dentro de la misma familia de modelos.
Elige imágenes cuadradas, verticales u horizontales en Picir AI con cinco relaciones de aspecto: 1:1, 4:3, 3:4, 16:9 y 9:16. La salida usa un ajuste fijo de 1K, con formatos JPEG, PNG o WebP.
Escribe una descripción en lenguaje natural, utiliza etiquetas o combina texto con un diseño estructurado. Puedes empezar de forma sencilla y añadir indicaciones de composición más precisas cuando sea necesario.
Utiliza texto, ilustración y controles de composición para una amplia variedad de proyectos visuales.
Explora pósteres, gráficos de título y conceptos de diseño que combinen texto e imágenes. Utiliza prompts estructurados para indicar dónde deben aparecer los elementos principales.
Desarrolla personajes, escenas con ambiente e ideas para historias ilustradas. Describe el tono, los materiales y las relaciones visuales en un prompt detallado.
Crea gráficos de anuncios, imágenes bilingües y conceptos visuales para publicaciones o presentaciones. Revisa cada titular generado antes de compartirlo.
Explora escenas de aula, notas manuscritas e ilustraciones con texto para contenidos explicativos. Comprueba tanto el texto como la exactitud de la información en la imagen final.
Describe tu idea, elige los ajustes de imagen y genera con MOSS Image.
Indica el sujeto, el entorno, el estilo visual y el texto deseado. La guía oficial recomienda el inglés; también se admiten prompts en chino.
Selecciona una relación de aspecto y el formato de salida JPEG, PNG o WebP. MOSS Image usa un ajuste fijo de 1K; elige cuántas imágenes quieres generar.
Genera tus imágenes y revisa los resultados en tu espacio de trabajo. Comprueba el texto y la composición, y ajusta el prompt para obtener otra versión.
Información del modelo y ajustes de generación de imágenes disponibles en Picir AI.
| Desarrollador | OpenMOSS Team |
| Fecha de publicación | 16 de octubre de 2026 |
| Modo de generación | Texto a imagen |
| Arquitectura del modelo | Transformer de difusión de 5.000 millones de parámetros |
| Formatos de prompt | Lenguaje natural, secuencias de etiquetas y diseños JSON |
| Entrada del prompt en Picir AI | Hasta 5.000 caracteres |
| Renderizado de texto | Chino e inglés |
| Resolución de salida | 1K (fija) |
| Relaciones de aspecto | 1:1, 4:3, 3:4, 16:9, 9:16 |
| Formatos de salida | JPEG, PNG, WebP |
| Control de composición | Posicionamiento experimental de texto y objetos mediante prompts JSON |
| Imágenes de referencia | Sin subida de imágenes; describe la imagen en el prompt |
Última actualización: 21 de octubre de 2026
Compara los dos checkpoints publicados juntos en la familia MOSS Image.
| Especificación | MOSS-Image-Base | MOSS-Image-SFT |
|---|---|---|
| Fecha de publicación | 16 de octubre de 2026 | 16 de octubre de 2026 |
| Función del checkpoint | Modelo base | Ajuste fino de Base con datos seleccionados |
| Red principal | 5.000 millones de parámetros | Misma arquitectura de 5.000 millones de parámetros |
| Formatos de prompt | Lenguaje natural, etiquetas, diseños JSON | Lenguaje natural, etiquetas, diseños JSON |
| Ventana del prompt | Hasta 4K tokens | Misma interfaz de la familia |
| Renderizado de texto | Chino e inglés | Chino e inglés |
| Control de composición | Experimental | Interfaz de diseño compartida |
| Ejemplo oficial de la pizarra blanca | Agrupación del texto menos organizada | Agrupación más clara y diseño más organizado |
Ventajas de MOSS-Image-Base: Base conserva un checkpoint fundamental para la adaptación y el ajuste fino personalizado, incluido el entrenamiento de LoRA.
Ventajas de MOSS-Image-SFT: SFT incorpora un ajuste fino con datos seleccionados y muestra una agrupación del texto más clara en la comparación oficial de la pizarra blanca.
Considera SFT si quieres evaluar la calidad de imagen sin ajustes adicionales, y Base si planeas adaptar o afinar el modelo. Compara ambos con tus propios prompts: un solo ejemplo publicado no demuestra una superioridad universal.
Elige un plan de Picir AI y utiliza créditos para generar imágenes con MOSS Image. Consulta a continuación el coste actual por imagen.
MOSS Image tiene un coste fijo en créditos por cada imagen generada. Los siguientes ejemplos muestran el coste de una imagen con el ajuste fijo de 1K.
| Ajustes de imagen | Créditos por imagen |
|---|---|
| Cuadrada · 1:1 · JPEG · 1K | 8 |
| Horizontal · 16:9 · PNG · 1K | 8 |
| Vertical · 9:16 · WebP · 1K | 8 |
La relación de aspecto y el formato de salida no cambian el coste por imagen. Si generas varias imágenes, cada una se cobra por separado.
Encuentra respuestas sobre prompts, diseños, versiones del modelo y límites de generación de imágenes.
MOSS Image es una familia de modelos de texto a imagen de OpenMOSS con una red principal de 5.000 millones de parámetros. Se publicó el 16 de octubre de 2026, incluye los checkpoints Base y SFT y admite imágenes fotográficas e ilustradas.
Sí. Ambas capacidades están documentadas y hay ejemplos publicados de escritura a mano y texto dentro de escenas. Aun así, debes revisar la ortografía, los saltos de línea y la integridad del texto.
No. La guía oficial describe los prompts de diseño como experimentales. Los cuadros delimitadores orientan la composición, por lo que el texto o los objetos pueden diferir de la posición o del tamaño solicitados.
MOSS Image en Picir AI genera imágenes nuevas a partir de texto y no admite imágenes de referencia subidas. Modificar un diseño JSON crea una composición nueva en lugar de editar una foto existente.
En Picir AI, MOSS Image usa un ajuste fijo de 1K y admite relaciones de aspecto 1:1, 4:3, 3:4, 16:9 y 9:16. Puedes elegir JPEG, PNG o WebP como formato de salida. La resolución es fija y no se puede seleccionar.
Describe el sujeto, el entorno, el estilo, la iluminación y el texto exacto que quieres ver. La guía oficial recomienda prompts en inglés y saltos de línea explícitos para el texto. También puedes combinar lenguaje natural, etiquetas y diseños JSON.
SFT es una versión de Base afinada con datos seleccionados. Ambos comparten la misma arquitectura e interfaz de prompts; SFT no es un modelo más grande ni de una generación posterior. El ejemplo oficial de la pizarra blanca muestra una agrupación del texto más clara con SFT.
Puedes usar el generador de imágenes IA MOSS Image en Picir AI. Introduce un prompt, elige los ajustes y genera tus imágenes directamente desde esta página.